總之就是重設 chrome
2020年7月8日 星期三

2020年6月25日 星期四
2020年5月19日 星期二
Stanford CoreNLP 發佈 4.0 版,指代消解功能大躍進
Stanford CoreNLP 發佈 4.0 版,可於 https://stanfordnlp.github.io/CoreNLP/index.html#download 下載


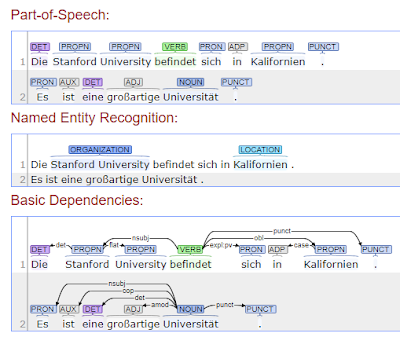

看看範例句子:
Stanford University is located in California. It is a great university.
 |
試試正體中文,結果斷詞依然不太行
簡體中文則正常工作,指代消解如文件所言是working的
此次提供的語言模型只有中英法德西阿6種,日印俄語表示或許過一段時間會有其它語種?且中英文以外均無指代消解功能
德文:
Die Stanford University befindet sich in Kalifornien. Es ist eine großartige Universität.
法文:
L'université de Stanford est située en Californie. C'est une grande université.
2020年4月27日 星期一
org mode 中執行 anaconda python 的設定(三)--ipython via ob-ipython(需裝 jupyter)
上篇文章的作法需指定檔名,感覺有點冗。這回我們試著用 melpa 的套件 ob-ipython 來解決
假設我們用的是 anaconda 下的 py35 環境,在此環境下安裝 jupyter,然後在 emacs 的設定:
(setq python-shell-interpreter "/Anaconda3/envs/py35/python.exe")
(org-babel-do-load-languages
'org-babel-load-languages
'((python . t) (ipython . t) ))
windows 平台需針對 windows 修改,參 https://github.com/jawatech/ob-ipython/blob/master/ob-ipython.el
或者直接在設定檔中改寫:
缺點的話如同 John Kitchin 所言,只能顯示一個圖,且無法顯示其它文字。JK 在該文提出了一些改良,但是後來融合到 scimax 而集其大成。這個小改我就跳過了,直上 scimax 真的是一個爽,有空再來寫一篇心得分享。

假設我們用的是 anaconda 下的 py35 環境,在此環境下安裝 jupyter,然後在 emacs 的設定:
(setq python-shell-interpreter "/Anaconda3/envs/py35/python.exe")
(org-babel-do-load-languages
'org-babel-load-languages
'((python . t) (ipython . t) ))
windows 平台需針對 windows 修改,參 https://github.com/jawatech/ob-ipython/blob/master/ob-ipython.el
或者直接在設定檔中改寫:
| (defun ob-ipython--get-python () | |
| (let ((buf ( or python-shell-interpreter "python"))) | |
| (locate-file buf exec-path))) |
缺點的話如同 John Kitchin 所言,只能顯示一個圖,且無法顯示其它文字。JK 在該文提出了一些改良,但是後來融合到 scimax 而集其大成。這個小改我就跳過了,直上 scimax 真的是一個爽,有空再來寫一篇心得分享。

2020年4月1日 星期三
org mode 中執行 anaconda python 的設定(二)
依之前所寫的文章 org mode 中執行 anaconda python 的設定 完成設定後,在 org mode 中可以執行程式片段,至於顯示圖片的寫法可參考 https://orgmode.org/worg/org-contrib/babel/languages/ob-doc-python.html
有幾個地方要注意

有幾個地方要注意
- 不再使用 :session 參考
- :results 設定傳回 file ,實際上是一個連結
- 需將圖片儲存為一個可顯示的檔案
- 需以 return 關鍵字回傳檔名

2020年3月17日 星期二
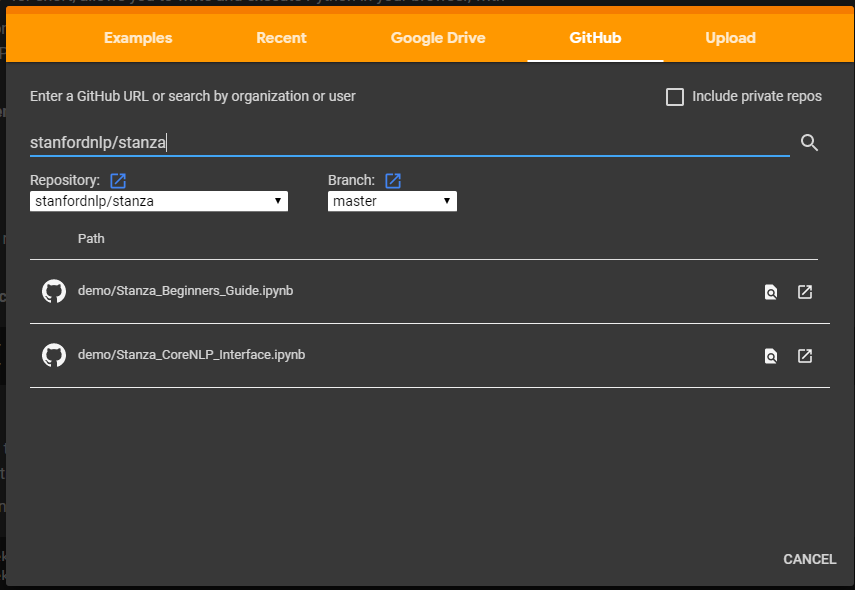
StanfordNLP 更名為 Stanza

2020年3月4日 星期三
以 scrapy 爬蟲抓 ptt 文章,兼論 Anaconda 下 venv 的使用
從頭刻一個當然可以,但有人已經寫好了,在 https://github.com/afunTW/ptt-web-crawler/tree/master/ptt_web_crawler
ptt-web-crawler 是一個沒有使用 scrapy 的專案,協作者 afunTW 將它 fork 了以後以 scrapy 進行改寫。我猜抓下來還是不能直接用,因此 fork 了以後才 clone。為了不影響原環境,並順便解答一些疑問,我在 anaconda 下先安裝了 scrapy ,然後在 clone 下來的目錄中,執行 python -m venv venv。然後新開一個 cmd 並進入 venv 環境,在同一目錄中執行 pip install -r requirements.txt。然後執行 scrapy crawl ptt-web -a board=Gossiping -a pages=1,2 發生三個問題,依序記錄如下
試著直接comment掉,結果沒問題。可能是我在上一步沒有指定 scrapy 的版本,結果直上 scrapy 2.0 的關係。diff 如下:
--- a/ptt_web_crawler/ptt_web_crawler/spiders/ptt_web_spider.py
+++ b/ptt_web_crawler/ptt_web_crawler/spiders/ptt_web_spider.py
@@ -8,7 +8,7 @@ from six import u
import scrapy
from ptt_web_crawler.items import PttWebCrawlerItem
-from scrapy.conf import settings
+# from scrapy.conf import settings
from scrapy.exceptions import CloseSpider
from scrapy.http import FormRequest
from scrapy.spidermiddlewares.httperror import HttpError
執行 scrapy crawl ptt-web -a board=Gossiping -a pages=1,2 發生第三個問題
from _sqlite3 import *
別的專案也遇到相同問題,迫使我回到 python 3.5 開發。看來直接由 cmd 進入新建的 venv 時無法取用 anaconda 已安裝的 sqlite3(以及 scrapy ,如果已經安裝了的話) ,因此必需在 anaconda 的 python 3.7 內進入 venv ,才能正常工作。至於若在新建的 venv 下重新安裝 scrapy ,也無法正常工作,仍然必需使用 anaconda 的套件才能正常工作。
光兩頁就快 1M 了,改天再來寫一篇這個 json 檔的後處理

ptt-web-crawler 是一個沒有使用 scrapy 的專案,協作者 afunTW 將它 fork 了以後以 scrapy 進行改寫。我猜抓下來還是不能直接用,因此 fork 了以後才 clone。為了不影響原環境,並順便解答一些疑問,我在 anaconda 下先安裝了 scrapy ,然後在 clone 下來的目錄中,執行 python -m venv venv。然後新開一個 cmd 並進入 venv 環境,在同一目錄中執行 pip install -r requirements.txt。然後執行 scrapy crawl ptt-web -a board=Gossiping -a pages=1,2 發生三個問題,依序記錄如下
scrapy 指令無法執行
我修改了 requirements.txt ,在最後加入 scrapy 一行,執行 pip install -r requirements.txt。然後執行 scrapy crawl ptt-web -a board=Gossiping -a pages=1,2 發生第二個問題ModuleNotFoundError: No module named 'scrapy.conf'
出自此行 from scrapy.conf import settings試著直接comment掉,結果沒問題。可能是我在上一步沒有指定 scrapy 的版本,結果直上 scrapy 2.0 的關係。diff 如下:
--- a/ptt_web_crawler/ptt_web_crawler/spiders/ptt_web_spider.py
+++ b/ptt_web_crawler/ptt_web_crawler/spiders/ptt_web_spider.py
@@ -8,7 +8,7 @@ from six import u
import scrapy
from ptt_web_crawler.items import PttWebCrawlerItem
-from scrapy.conf import settings
+# from scrapy.conf import settings
from scrapy.exceptions import CloseSpider
from scrapy.http import FormRequest
from scrapy.spidermiddlewares.httperror import HttpError
執行 scrapy crawl ptt-web -a board=Gossiping -a pages=1,2 發生第三個問題
ImportError: DLL load failed: 找不到指定的模組。
File "C:\Anaconda3\envs\python 3.7\lib\sqlite3\dbapi2.py", line 27, infrom _sqlite3 import *
別的專案也遇到相同問題,迫使我回到 python 3.5 開發。看來直接由 cmd 進入新建的 venv 時無法取用 anaconda 已安裝的 sqlite3(以及 scrapy ,如果已經安裝了的話) ,因此必需在 anaconda 的 python 3.7 內進入 venv ,才能正常工作。至於若在新建的 venv 下重新安裝 scrapy ,也無法正常工作,仍然必需使用 anaconda 的套件才能正常工作。
Results
結果會存在 data\Gossiping\Gossiping_page_1_2.json光兩頁就快 1M 了,改天再來寫一篇這個 json 檔的後處理

訂閱:
文章 (Atom)


