https://github.com/ropensci/fulltext
真心希望早日打破各出版社聯合壟斷的局面
2015年7月24日 星期五

2015年7月20日 星期一
" 大數據(big data)"之"方法論(methodology)"
http://www.36dsj.com/archives/247 這篇講得不錯,四平八穩
http://www.36dsj.com/archives/8911 這篇從ML的角度來講,所以偏向AI
在規則的發現上,有兩種方式,一種從統計的角度出發(Association Rules),一種從NLP的角度下手(Grammar Induction)
http://blog.csdn.net/gjwang1983/article/details/45015203
http://blog.csdn.net/qq_25684755/article/details/46584805
https://github.com/dengyishuo/Top10Algorithm/blob/master/apriori/arules.md
應用在文字探勘,有以下應用
http://blog.csdn.net/u013946794/article/details/44246569
http://qxde01.blog.163.com/blog/static/6733574420132915952828/
http://qxde01.blog.163.com/blog/static/673357442013355192638/
http://www.36dsj.com/archives/8911 這篇從ML的角度來講,所以偏向AI
在規則的發現上,有兩種方式,一種從統計的角度出發(Association Rules),一種從NLP的角度下手(Grammar Induction)
關聯式規則(Association Rules, AR)
https://zh.wikipedia.org/wiki/%E5%85%B3%E8%81%94%E5%BC%8F%E8%A7%84%E5%88%99http://blog.csdn.net/gjwang1983/article/details/45015203
http://blog.csdn.net/qq_25684755/article/details/46584805
https://github.com/dengyishuo/Top10Algorithm/blob/master/apriori/arules.md
應用在文字探勘,有以下應用
http://blog.csdn.net/u013946794/article/details/44246569
http://qxde01.blog.163.com/blog/static/6733574420132915952828/
http://qxde01.blog.163.com/blog/static/673357442013355192638/
2015年7月19日 星期日
程式語言間的語法比較: RosettaCode.org
以 perl 常用的 map / grep 為例
http://rosettacode.org/wiki/List_comprehensions#Perl
有中文的介紹可參考
http://rosettacode.org/wiki/List_comprehensions#Perl
有中文的介紹可參考
这个网站的要旨到底是什么?比如说你会 A 语言,又想看看如果用 B 语言写的话会如何。那么通过很多问题的解决的对比,你应该可以了解到 B 语言的语法,以及它跟你会的 A 语言的关系了。然后你就会注意到语言的设计模式和行为——也就是这门语言的习惯。你也会看到哪些习惯你已经有了,哪些习惯正则阻碍你的发展。
2015年7月18日 星期六
ubuntu下對應到ultraedit的find in files的指令
http://edsionte.com/techblog/archives/3164
以前只會一招,就是用find搭配grep xargs,但是語法不好記,指令又長
這篇介紹的 grep -R -w -n "關鍵字" "目錄",非常好用
現在我幾乎找不到任何原因在 windows 下寫程式了…
2015年7月17日 星期五
heatmap究竟能畫得多複雜?

heatmap 的語法可參考
提到的"微博"(大陸的山寨版tweet)有以下幾個
http://www.weibo.com/fly51fly
http://www.weibo.com/haoawesome
https://github.com/PuddingNnn/Rweibo/blob/master/topic/topicmodel.R
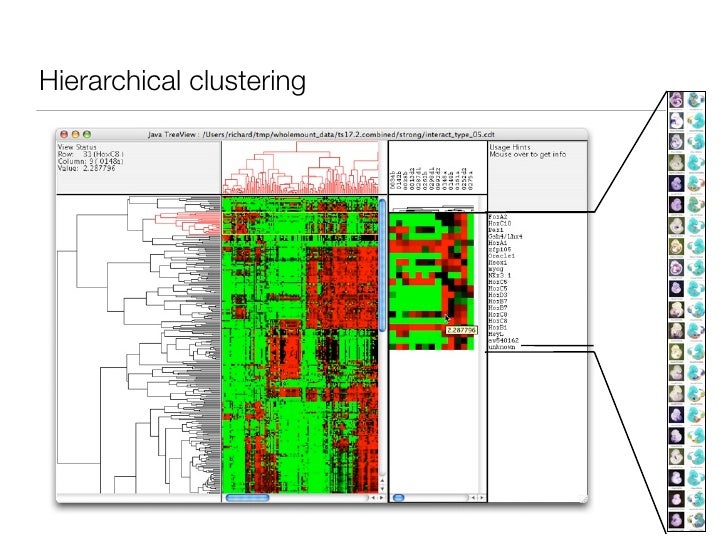
http://www.slideshare.net/jvhemert/escience-research
2015年7月14日 星期二
R的語法之"快快樂樂學"(喵的該不會真有這本書吧XD)
http://joe11051105.gitbooks.io/r_basic/content/variable_and_data/vector.html
我最欣賞這段講下標的部分

所以從 perl 的角度來看,它既是 array 又是 hash 囉?!
我最欣賞這段講下標的部分

所以從 perl 的角度來看,它既是 array 又是 hash 囉?!
2015年7月11日 星期六
在ubuntu上用R進行中文 Text Mining
- 先備知識:R语言环境下的文本挖掘 , R之文本挖掘 , 数据科学18:文本挖掘1 。嚴格來說這幾篇都是翻譯自 tm 模組作者的這篇文章: Introduction to the tm Package Text Mining in R
- 範例: https://github.com/JohnsonHsieh/ecfa/blob/master/myText2.R ,是一個完整的專案
- 上述github專案主要參考這篇文章 ;基本上文章寫成至今已經兩年多了,ptt的一些網頁協定(https)可能有改(推測在2014年的4月到8月間,如 "www.ptt.cc/bbs/StupidClown/index" 改成 "https://www.ptt.cc/bbs/StupidClown/index") , 因此抓取文章的部分建議參考以下所列的網頁
- https://www.snip2code.com/Snippet/143970/-anted-Sna ,特色在於未使用 rwordseg ,單純看推文者和作者間的關係
- https://github.com/agilearning/RPTT/blob/master/R/RPTT.R ,有三個函數可供使用,以抓取索引頁、文章連結、文章內容 ; 同作者另起了新的專案,附上函數的使用範例,可參考 https://github.com/agilearning/RTextMining
- 其它潛在應用可參考 rfacebook ,可以抓 FB 上的文章
英文 text mining 資源
https://cran.r-project.org/web/views/NaturalLanguageProcessing.html
http://www.rdatamining.com/examples/text-mining
http://faculty.chicagobooth.edu/matt.taddy/teaching/text.R
http://search.cpan.org/~davor/Statistics-R-IO-0.101/lib/Statistics/R/IO.pm
http://search.cpan.org/dist/Statistics-RserveClient-0.12/lib/Statistics/RserveClient.pm
http://search.cpan.org/~fangly/Statistics-R-0.33/lib/Statistics/R.pm
http://www.amazon.com/Roger-Bilisoly/e/B001JSCDN4/ref=ntt_dp_epwbk_0
http://lopen.linguistics.ntu.edu.tw/PTT/
這個網站很有趣,是台大語言所架設的,包含了2014年起收集的 ptt 語料,中文斷字詞的線上查詢。
其它服務還有:前後綴、相關字、情緒判別, api 要註冊才能用來下載 ptt 文章(還好目前看來是免費的), wordcloud 目前提供 gossiping / hate 兩個版的輸出。看來用的是中研院的斷詞,搭配自建字庫不是經常更新的樣子。

與 perl 的協作
http://search.cpan.org/~davor/Statistics-R-IO-0.101/lib/Statistics/R/IO.pm
http://search.cpan.org/dist/Statistics-RserveClient-0.12/lib/Statistics/RserveClient.pm
http://search.cpan.org/~fangly/Statistics-R-0.33/lib/Statistics/R.pm
計算語言學
http://www.amazon.com/Roger-Bilisoly/e/B001JSCDN4/ref=ntt_dp_epwbk_0
http://lopen.linguistics.ntu.edu.tw/PTT/
這個網站很有趣,是台大語言所架設的,包含了2014年起收集的 ptt 語料,中文斷字詞的線上查詢。
其它服務還有:前後綴、相關字、情緒判別, api 要註冊才能用來下載 ptt 文章(還好目前看來是免費的), wordcloud 目前提供 gossiping / hate 兩個版的輸出。看來用的是中研院的斷詞,搭配自建字庫不是經常更新的樣子。

訂閱:
文章 (Atom)


